
Gemini 4 Neon:快速代理式工作流程的架構設計
分享這篇文章:
Gemini 4 Neon 對代理式工作流程的實際價值,不在基準榜單名次,而在 Google 為它設計的協調者與執行者架構:Neon 規劃、驗證任務,再把執行工作交給更輕量、更快速的 Hydrogen 子代理。但要讓這種架構在生產環境可靠運行,必須正確分配 token 預算。Neon 的 100 萬 token 上下文,是輸入、推理與輸出共用的單一額度,不是輸入 100 萬之外還有額外的輸出 100 萬。若誤以為兩者分開計算,代理迴圈最終答案可能在沒有明顯提醒的情況下被截斷。
Neon 的定位與適用範圍
Neon 改編自 Gemini 4 Carbon,位於 Google 模型組合的中間:Carbon 處理最困難、最長時間的專案;Hydrogen 負責快速的日常執行;Neon 則在兩者間取得平衡,針對複雜程式開發、分析推理,以及需要快速、反覆使用前沿推理能力的企業級工作流程。定價也反映這項定位:Neon 每百萬輸入 token 3 美元、輸出 token 15 美元,高於 Carbon 與 Argon 的入門費率,約為 Hydrogen 的兩倍。它提供 low、medium、預設 high 與 xhigh 四種思考等級,讓團隊依回應深度與 token 支出調整,而不必只能選固定的能力層級。
Google 為 Neon 設計的協調者與執行者模式
工作如何交接
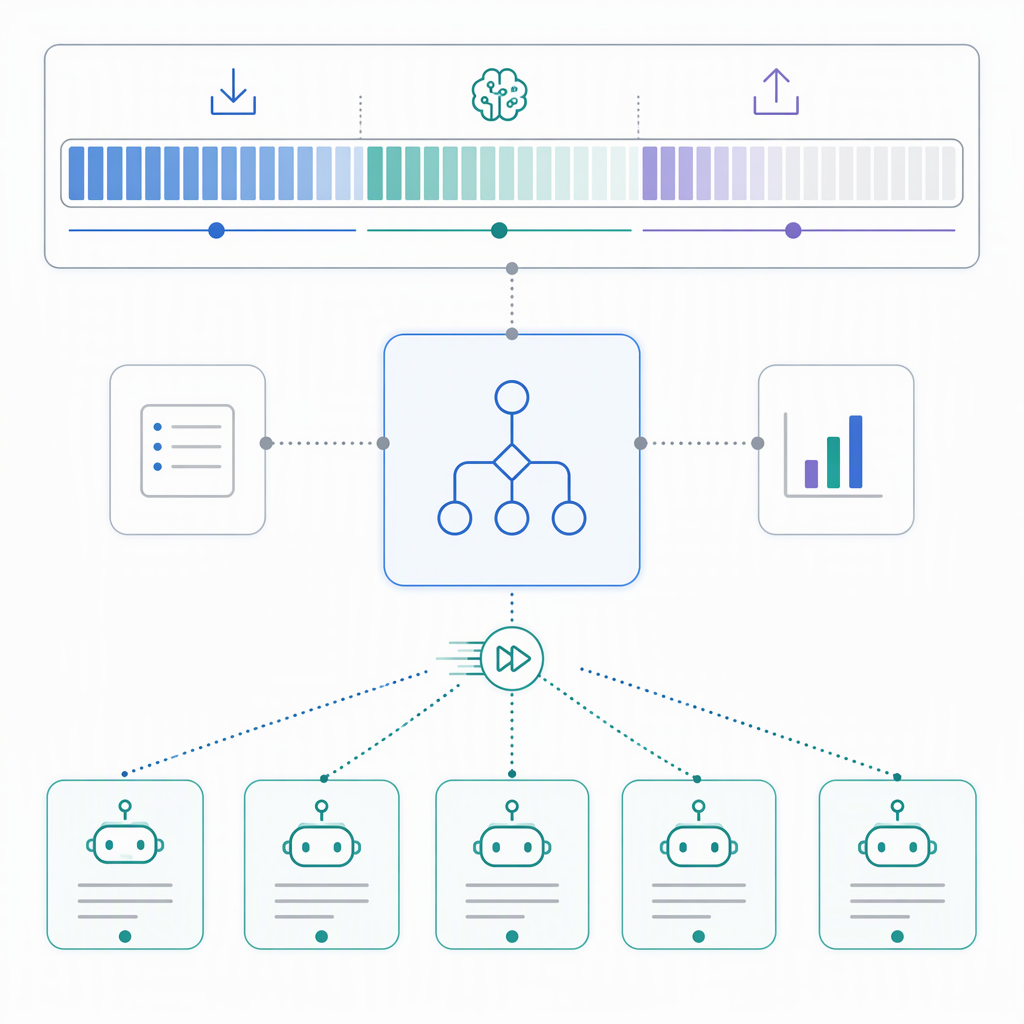
Google 對 Neon 記錄了具體的多模型模式:先由 Neon 規劃並驗證多步驟的軟體工程或分析流程,再透過 Interactions API 的 previous_interaction_id,將工作交給延遲較低的 Hydrogen 子代理執行。這是業界常見的協調者與執行者思路:較強的模型負責規劃,較便宜、較快的模型完成各個步驟;不同的是,這裡提供同一模型家族內的第一方交接機制,不必自行串接不同供應商。若要建立快速的代理式流程,應及早明確分工:讓 Neon 處理規劃、驗證與判斷,把重複的執行步驟交給 Hydrogen,而不是預設每一步都由較重、較貴的模型完成。
生產環境中最容易破壞代理迴圈的 token 預算錯誤
輸入 90 萬 token,其他部分最多只剩 148,576 token
「100 萬上下文」容易使人誤解。Neon 的上下文窗口上限是 1,048,576 token,所有 API 介面的輸入與輸出共用這個額度;輸出又包括思考 token、函式呼叫與最終回應。若一項請求用了 900,000 個輸入 token,推理和輸出合計最多只剩 148,576 個 token,不會再獲得一份獨立、完整的輸出額度。單次同步回應的輸出上限仍是 65,536 token;若要繼續產生內容,須明確使用帶有 continuation token 的 long-decode 模式,且延伸輸出也只能使用剩餘額度。實際風險是:max_output_tokens 設得太低,模型內部思考已先消耗額度,最終答案還未寫完便被截斷。若代理流程會向 Neon 輸入大型文件或長對話紀錄,應事先計入這些消耗,而不是把標示的上下文大小誤認為兩個獨立的百萬 token 池。
工程判斷:採用前應驗證什麼
Google 發布的基準成績應視為測試起點,而非定論。Neon 一項主要宣傳數字——Vals Index 成績——在獨立評論者檢查公開榜單時仍未出現,因此當時外界尚無法在該榜單重現供應商公布的數據。應以具代表性的自身任務,比較 Neon、Hydrogen 與目前使用的模型,按固定規準評估品質,同時記錄實際計費 token、重試次數與耗時,不能只看輸出是否表面合理。
若已在生產環境使用 Argon,還要留意產品生命週期。Neon 在面向消費者的 Gemini App 中取代了 Argon,Argon 已不在該介面提供;但 API 仍可使用 Argon 的入門費率至 11 月底,之後價格翻倍,而截至本文撰寫時尚未發布淘汰通知。這類不顯眼的產品重新定位值得記入自己的模型清單,不應等帳單或存取方式改變才發現。
在 SIRAYA,真正從 Gemini 4 Neon 獲得吞吐量改善的團隊,會把它當成兩項獨立決策:先依自身流程明確劃分 Neon 的規劃角色與 Hydrogen 的執行角色,再建立涵蓋輸入與輸出共用額度的 token 預算模型。若生產環境最終答案被截斷,原因可能不是模型能力,而是預算假設與上下文窗口的實際運作方式不符。