
Claude Fable 5.2 與 Mythos 5.2:存取權、安全防護與適用情境
分享這篇文章:
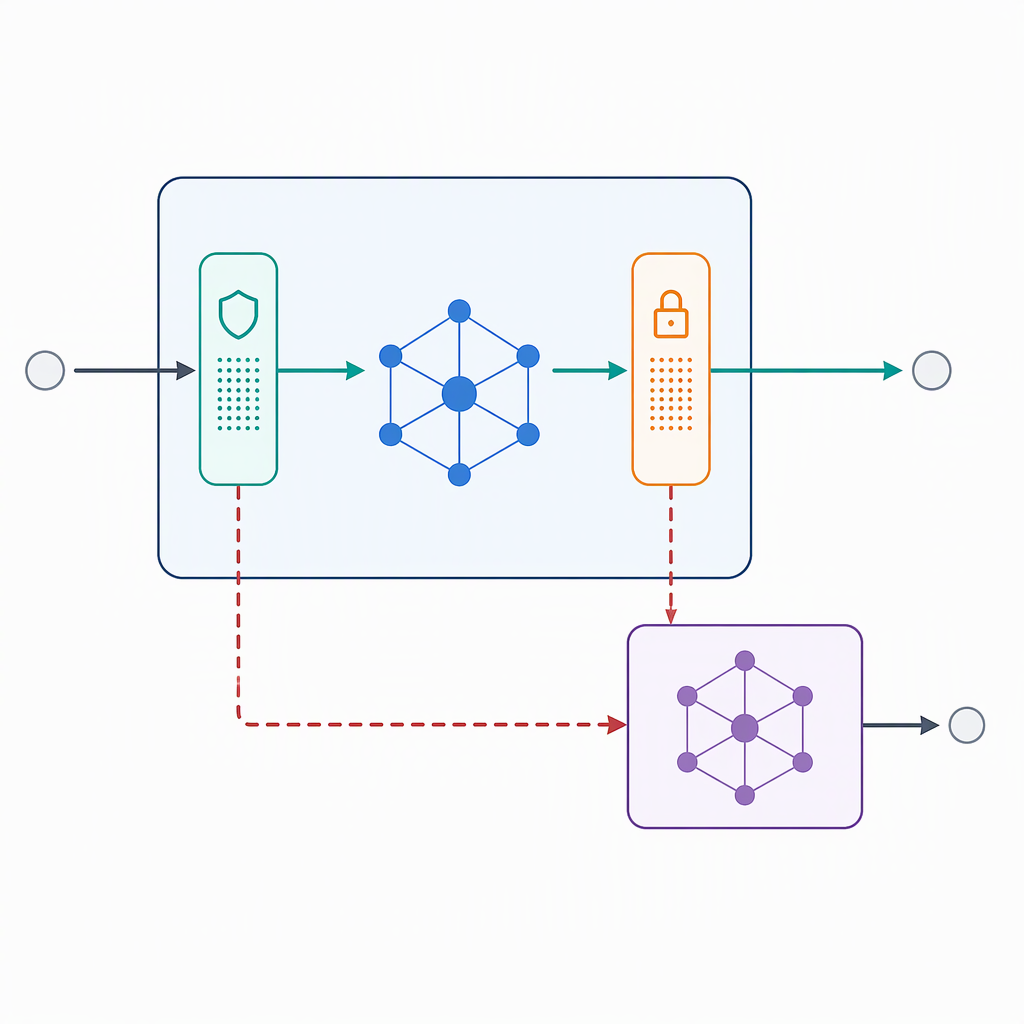
Claude Fable 5.2 與 Claude Mythos 5.2 使用相同的底層模型,因此兩者之間的選擇,核心在於存取資格與安全防護,而非能力高低。工程團隊更該問的是:自己的工作是否涉及 Fable 防護機制會攔截的資安或生物學任務?若涉及,被攔截時究竟會發生什麼事?常見誤解是請求會直接失敗;實際上,系統可能在同一次 API 呼叫中改由另一個能力不同的模型回答。標準評估流程往往不會顯示這種情況。
相同模型,不同的安全防護層
Anthropic 明確表示,Fable 5.2 與 Mythos 5.2 共享一個底層模型,差異是安全分類器。Fable 具有資安與生物學防護,所有付費 Claude 訂閱者及 API 客戶都可使用,無須另行申請。Mythos 移除了相關防護,僅開放給通過 Anthropic Cyber Verification Program 或 Life Sciences Verification Program 審核的組織;Claude Enterprise 客戶也可透過 Claude Security 使用 Mythos 的漏洞掃描能力,無須另行驗證。兩者價格相同,均為每百萬輸入 token 8 美元、輸出 token 40 美元,較 5.1 代降低 20%;fast mode 的費率翻倍,輸出速度最高可達 2.5 倍。若單純按「哪個比較聰明」選擇,就選錯了比較變數;真正的差別是誰有資格移除安全限制。
一般評估容易漏掉的替代回答風險
被攔截的請求不一定失敗,而是改由其他模型回答
當 Fable 5.2 的分類器攔截請求時,資安查詢會改由 Claude Opus 4.8 回答,生物學查詢則由 Claude Opus 5 回答;兩者都是與原先呼叫不同、通常在相關高難度任務上較弱的模型。這會發生在同一次 API 回應中,沒有一個獨立的錯誤碼替你區分「原指定模型回答」與「因安全防護改由其他模型回答」。如果工作位於資安或生物學邊界,例如安全研究、漏洞分流、生物資訊分析,或合法但容易被分類器判為雙重用途的任務,就應直接測試這項生產風險。若評估集只有明顯無害的提示詞,替代回答永遠不會被觸發;團隊可能因此把整合上線,卻不知道某些真實請求的品質會無聲下降。
這一代誤攔率的改善具有實際意義。Anthropic 表示,Fable 5.2 的整體攔截次數較 Fable 5.1 約少 55%,其中資安類約少 60%,生物學類約少 40%;這反映上一代確實會攔住一定比例的合法工作。但改善並未消除替代回答,只是降低其發生頻率,也使測試更容易漏掉它。
Mythos 存取權也受外部因素影響
通過驗證計畫,只是取得存取權的一部分。這類分級能力曾因外部監管措施而暫停,與個別客戶是否合規無關。2026 年 6 月 12 日,美國一項出口管制指令迫使 Anthropic 對所有客戶停用 Fable 5 和 Mythos 5,直到 7 月 1 日才恢復。將近三週內,即使是已通過驗證、用途正當的組織也完全失去存取權。因此,依賴 Mythos 的生產系統除了面對一般供應商故障與版本淘汰,還須承擔地緣政治與監管造成的可用性風險。以 Mythos 建立資安或生命科學流程的團隊,應為這類特定失效情境制定回退方案,而不只是準備一份籠統的供應商故障手冊。
工程判斷:依工作負載選型並控制成本
Anthropic 自己的建議值得採納:多數程式開發與知識工作先使用 Opus 5.5;只有最困難、真正需要長時間執行的代理任務,再升至 Fable 或 Mythos。Fable 的每 token 費率是 Opus 5.5 的兩倍,長時間代理工作會迅速放大成本。早期測試中,已有從頭到尾使用 Fable 的大型代理專案產生五位數美元帳單,提醒團隊:高能力模型若無監督地運行數小時或數日,成本控制與能力同樣重要。可採用 Anthropic 為此層級提出的 advisor/orchestrator 模式,由 Fable 或 Mythos 指導較便宜的執行模型完成大部分工作,而不是預設每一步都使用昂貴模型。不論模型測試表現多好,關鍵且不可逆的動作仍應保留人工核准;Anthropic 團隊也指出,長時間無人監督代理的可靠性仍是未解問題。
在 SIRAYA,我們審視這類模型時,比起榜單位置,更關心兩個具體問題:評估集有沒有真正覆蓋 Fable 安全防護被觸發的邊界?生產回退方案有沒有考慮整個存取層因客戶無法控制的原因而消失?一般模型比較往往無法顯示這兩種失敗情境。