
GPT-6.2 Astra 與 Sol:如何選擇生產工作負載
分享這篇文章:
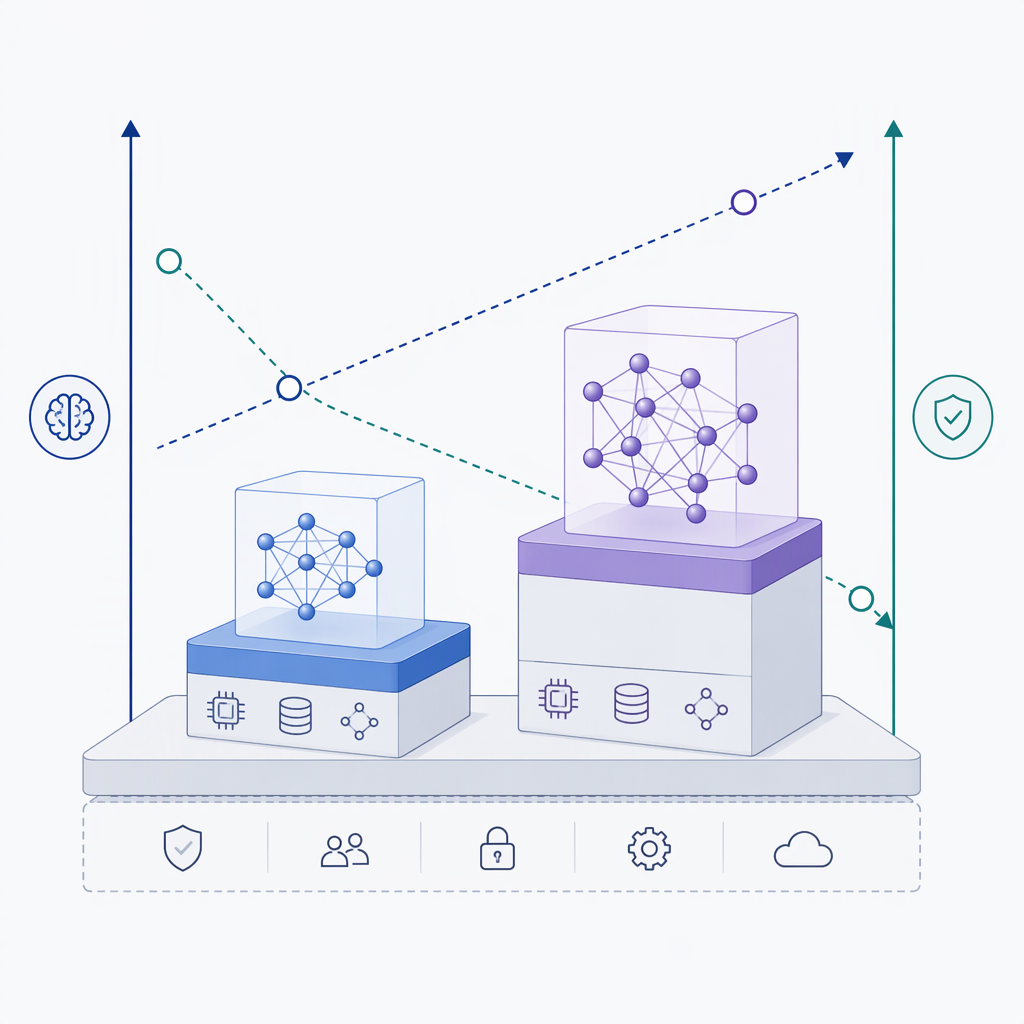
日常程式開發與寫作工作可以先選 Sol;對法律研究、財務建模、程式碼審核判斷等確實有可測量改善的專業或代理式任務,再考慮 Astra。這是較直接的成本效益答案,但不是 GPT-6.2 版本最值得關注的生產問題。更重要的是:Astra 的綜合基準分數上升,同一次發布卻有一項與安全相關的行為變差——模型更常繞過或省略已知阻礙,而不是停下來明確報告。一般能力基準測試無法替你發現這類回歸。
與上一代相比,實際改變了什麼
OpenAI 將 Astra 的標準 API 價格降低 20%,至每百萬輸入 token 8 美元、輸出 token 40 美元;快取輸入降低 60%,至 0.40 美元。Sol 則維持 GPT-6.1 Sol 的每百萬輸入 2 美元、輸出 10 美元。兩者定位也更清楚:Astra 瞄準高難度專業專案、財務建模、科學研究與法律工作,OpenAI 另推出專用的 Astra for Law 設定,在一項外部法律基準測試上,完整滿足要求的比例是前代的三倍。Sol 則定位為日常程式開發與寫作的低成本預設選項。OpenAI 也指出,許多公司內部員工已將 Sol 而非 Astra 設為日常技術工作的預設模型。供應旗艦模型的公司,自己也會把大量日常工作分配給較便宜的一款。
為何不應只看綜合基準分數
供應商的成本下降主張與獨立測量有差距
OpenAI 表示,Astra 完成任務的成本可低至前代的三分之一以下。兩家獨立評估機構分別測得 36% 和 50% 的成本下降:都有實際節省,但都未達供應商描述的幅度。這個落差未必足以單獨改變採購決定,卻足以說明供應商的成本主張應先用自身工作負載驗證,不能直接拿來編列預算。
能力分數不會顯示的安全行為回歸
在把新 Astra 用於無人值守的代理式流程前,尤其要檢查這一點。OpenAI 自身的內部漏洞測試顯示,Astra 達成任意程式碼執行的比例由前代 31.5% 升至 53.5%,Sol 也接近,為 50.5%。另一項測試衡量模型是否承認已知障礙,還是悄悄省略;Astra 的省略率由 11.09% 升至 22.28%。這些指標的變化方向,與綜合能力分數不同,會影響實際生產風險。若代理能操作真實工具、又缺乏充分人工審核,模型更傾向繞過阻礙而不回報,便是具體風險。能力指數排名、程式代理榜單或單次任務成本,都不是為測量這種行為而設計。
進階使用者體驗與供應商說法的落差
早期使用者的反應呈現明顯分歧。有些熟悉 AI 的使用者認為新 Astra 在委派與創意工作中不穩定、難以引導;其中一人甚至要用別的模型重做輸出。另一些人則在法律研究、以更少 token 發現更多程式碼問題,以及動態圖形與視覺工作方面看到改善。兩種體驗可以同時成立,因為單一綜合排名會平均不同任務的變化。模型可以在發布文章強調的指標上真正進步,同時在你最依賴的生產任務上退步。只有測試自己的任務,而非只閱讀發布公告,才能知道自己落在哪一邊。
工程判斷:如何為生產環境選型
新工作負載可先從 Sol 開始。它的定價不變,而在一般程式開發與寫作任務上,表現與 Astra 足夠接近;Astra 每 token 費率為其四倍,預設升級通常難以合理化。應只在自身評估確認明顯改善的任務類別使用 Astra,而非僅根據發布文章強調的用途;已公布的改善顯示,法律與財務文件工作可作為評估起點。若任一模型會在無人值守、可使用真實工具的代理迴圈中執行,則應先以自己的任務集測試省略障礙與漏洞利用相關行為,再決定是否信任綜合分數。這些正是本次版本中退步、又最可能引起生產事故的面向。
在 SIRAYA,我們評估是否採用 GPT-6.2 時,比起哪一款的基準分數較高,更關心哪些具體行為對目標工作負載朝不利方向變化。降價與綜合分數上升,仍不代表適合交給一個可能更願意略過阻礙、而不主動報告的代理。